王曦研究苑

中国AI大模型蒸馏路线 vs 美西方预训练模式:熬老汤与做浓汤宝,是两条路吗?

引言

一锅汤的两种做法

想象一下,你走进一家顶级米其林餐厅。
主厨花了两天两夜,用最顶级的食材、最大的锅,熬出了一锅世界一流的高汤。
成本极高,配方保密,只卖成品。


隔壁街上,另一位厨师厨房小、燃气少、预算有限。
他把那锅高汤买过来,用现代工艺浓缩成一小块浓汤宝,再按本地口味加点葱姜蒜,开成了连锁快餐。
便宜、快、能铺到全国各地。


2026年的全球AI格局,大致就是这个画面。
美国在“熬老汤”,中国在“做浓汤宝”。

这背后涉及一个核心技术概念——知识蒸馏(Knowledge Distillation)
它由Geoffrey Hinton等人于2015年正式提出,核心思想是让小模型(学生模型)学习大模型(教师模型)的输出分布,而非仅仅学习硬标签。
蒸馏时通常使用较高的温度参数(如T=4到20),让学生模型能更清楚地看到教师模型对各类别的相对判断。


正是这项技术,叠加后训练优化与开源策略,正在催生一条与美西方截然不同的大模型发展道路。
这并非简单的技术强弱之分,而是由各自要素禀赋——算力、资本、电力、数据——所决定的战略分化。


算力之困与蒸馏之解:中国为什么走了一条不同的路

要理解中美AI路线的分化,首先要理解一个关键约束:高端算力芯片的出口管制

美国对中国先进AI芯片的出口限制,本意是拖慢中国AI发展。
但实际效果恰恰相反——它倒逼出一套更强调系统优化、编译器、蒸馏和开源权重的高效率技术路线。
海外顶级风投的调研备忘录明确指出,出口管制并没有简单拖慢中国AI,反而催生了一种全新的技术范式。


这套范式的核心杠杆就是蒸馏。
逻辑很朴素:训练一个前沿大模型,需要高端芯片、庞大集群、海量数据和长期投入
国内算力受限,很多公司根本承担不起完整预训练。
而直接使用开源模型,再加上合成数据和蒸馏,几个月就能得到一个看起来不错的模型。


蒸馏在这个过程中扮演的角色,就像前文“浓汤宝”比喻所揭示的——它不是替代熬汤,而是把别人熬好的汤以极低成本浓缩、提纯、分发
用少量算力从强模型中提取知识,成为绕开算力瓶颈的技术路径。

但这里必须纠正一个常见误解:中国的技术路线绝不仅仅是蒸馏
以DeepSeek为例,其V3模型的完整训练仅耗费278.8万H800 GPU小时,按每小时2美元的租用价格计算,总训练成本约557万美元。
这一成本仅为国际同等规模模型的5%到10%。
更关键的是,DeepSeek-R1的核心突破来自强化学习(RL)提升推理能力——R1-Zero在512张H800 GPU上训练198小时完成,R1在此基础上80小时完成核心训练阶段,总增量训练成本仅29.4万美元。

正如有分析所指出的,中国AI的进步不能被简单归结为蒸馏。
后训练方法正在从现有基础模型中提取更多推理能力,这些系统改变了模型的构建和运行方式,同时降低了训练和服务成本。


熬老汤的逻辑:美西方的预训练 Scaling 范式

理解了中国的约束条件,再来看美国的路径就清晰了。

美国AI模式的核心是预训练阶段的规模扩展(Scaling Law),信奉“更大的模型 + 更多的数据 + 更强的算力 = 更强的智能”。
这就像米其林餐厅不计成本地熬一锅高汤——买最贵的食材,建最大的中央厨房,追求极致品质。


以xAI的Grok-3为例,其训练动用了约20万块最先进的H100芯片。
这种“飞机大炮”式的资源密集型路径,追求的是通用人工智能的能力上限。
它的逻辑是:只要老师足够聪明,学生自然能学到最好的东西


然而,这条路线正在遭遇一个被学术界反复验证的悖论——教师模型并非越强越好。
苹果的研究发现,学生模型的损失随教师模型损失降低整体呈下降趋势,但如果教师模型能力过强,学生模型性能反而会恶化。
清华团队进一步揭示,模型“解题的正确率”和“思考的思维方式”是两个截然不同的维度,在某些主观评价场景中,仅模仿教师的答案正确性远远不够。
南京大学的研究也发现,性能更强的教师产生的概率向量区分度反而更低,导致“能力失配”现象——即性能极佳的大模型反而无法教好小模型。

这个学术发现意味深长:熬一锅更浓的汤,不一定能教出更好的徒弟。


做浓汤宝的逻辑:中国的后训练与蒸馏效率范式

如果说美国路径追求的是“造一个更聪明的老师”,中国路径追求的则是“培养大量高效的学生”。

中国的技术范式可以概括为三个关键词:后训练(Post-Training)蒸馏开源

用教育的比喻来说:美国花大钱请诺奖得主从零培养超级天才;中国把名师的课录下来,提炼成精华笔记、错题本、押题卷,快速培训大量学生。
目标是“让更多学生考得不错”。


北大团队曾将模型参数量压缩至5%,在数学推理等任务上达到了与满血R1几乎持平的精度。
这种效率令人瞩目。
但值得强调的是,中国头部模型的表现仅靠蒸馏无法解释——蒸馏在中国更多扮演的是加速技术扩散、降低部署成本的工程杠杆,而非替代底层创新的“捷径”

用一个更贴近生活的比喻来说:中国模式像把F1赛车的技术拆解、学习、优化,做成省油、耐用、便宜的家用车,然后量产上路
但中国顶尖实验室并不满足于只造家用车——他们也在自己研发发动机


生态逻辑:开源“集团军” vs 闭源“高墙”

技术路线的分化,直接映射到生态策略上。

美国AI巨头多数采取闭源模式,通过API进行有限的能力输出,形成商业壁垒。
OpenAI的GPT系列、Anthropic的Claude,都是闭源的代表。
这种模式的核心逻辑是:汤只卖成品,不告诉你配方。


中国则选择了开源策略。
DeepSeek-R1阿里Qwen智谱GLM,均发布开源权重。
这相当于把浓汤宝的配方公开,大家一起开分店。

开源策略带来了一个出乎意料的结果。
阿里Qwen系列已开源超460个模型,衍生模型数量突破20万个,成为全球首个达成此目标的开源大模型。
2026年上半年,Qwen在Hugging Face上的下载量达到约20.45亿次,远超Google的4.18亿次和Meta的2.27亿次。
中国自研开源模型下载占比达到41%,首次超过美国成为该平台规模第一的开源模型供给方。


数据背后是一个更深层的变化。
在OpenRouter平台上,中国模型的Token份额从2025年1月的6.0% 飙升至2026年7月的61.5%,前十大模型中有7个来自中国厂商。
在不到18个月内,中国服务商的Token流量占比从不足2% 跃升至超过45%。
约80% 的美国AI初创企业在生产环境中至少部署了一款中国开源模型。

这形成了一个耐人寻味的跨太平洋循环:美国训练前沿模型中国蒸馏并开源美国应用公司再微调变现


争议的焦点:蒸馏是“捷径”还是“创新”?

这条路线的成功,引发了美国政府和部分企业的强烈反弹。

2026年2月,Anthropic指控DeepSeek月之暗面MiniMax三家中国AI实验室对其Claude模型发动了“工业级别的蒸馏攻击”,声称这些公司设立超过2.4万个假账号,对Claude下达逾1600万次指令。
2026年9月,美国NSA、CISA、FBI联合指控六家中国AI公司进行“工业规模蒸馏”。
白宫科技政策办公室主任向各联邦机构发送备忘录,将中国对美国AI系统的蒸馏列为重点问题,并威胁实施制裁。


然而,这场指控有一个尴尬的背景。
在同一时期,埃隆·马斯克在法庭证词中承认,他创立的xAI曾利用OpenAI的模型进行蒸馏训练,并称“所有AI公司都这么做”。
更令人玩味的是,曾经的全球开源霸主Meta被彭博社曝出,其最新AI模型“牛油果”项目正在秘密使用阿里巴巴的千问Qwen开源模型进行蒸馏训练。
Meta的训练语料中已写入千问的推理输出,用于提升代码生成与多轮对话指标。

从法律角度看,蒸馏的合法性处于一个“光谱”之中。
单纯违反反蒸馏服务条款,最稳妥的责任基础是合同违约,而非刑事犯罪。
Anthropic自己的博客也承认蒸馏是“广泛使用的合法训练方法”——问题在于合约层面,而非犯罪层面。
但美国政府的做法值得注意:
它把原本属于服务条款、知识产权和商业竞争范畴的争议,提升到了国家安全和地缘科技竞争层面。


中方对此明确反驳。
商务部表示美方指控“于事无凭,于法无据”,并指出美方罔顾中国企业模型与美前沿模型发布时间非常接近、中国部分模型能力已处于领先地位等事实。

争议的核心其实是一个更深层的问题:蒸馏究竟是技术捷径,还是创新本身?

批评者认为蒸馏存在“教师模型天花板”。
学术研究确实表明,学生模型性能会在一个损失底线上饱和,这一底线在不同训练方法、目标和超参数选择下都持续存在。
长期依赖外部输出,可能将自身上限交给对手。

但支持者指出,中国头部模型的表现仅靠蒸馏无法解释。
DeepSeek-R1登上了《自然》封面,首次公开了训练成本与技术架构,其核心突破恰恰来自强化学习提升推理能力,而非蒸馏
蒸馏在中国更多扮演的是加速技术扩散、降低部署成本的工程杠杆,而非替代底层创新的“捷径”。


两条道路,两种“智能”哲学

现在回到开头那个比喻。

美国是“用钱和算力堆出一个超级老师”,中国是“用工程和开源把老师的本事压成压缩包,快速发给所有人”。
一个追求能力上限,一个追求普及效率

但比喻只是帮助理解,不是绝对事实。

这两条道路并非互斥,而是全球AI生态中互补的两个环节。
美国实验室探索前沿能力的边界,中国实验室则将这些能力以极低成本“提纯”并扩散至千行百业。
正如调研备忘录所指出的,未来竞争的关键可能不在于“谁的模型更强”,而在于谁能更快解除自身最稀缺的约束,以及AI价值最终流向基础模型、算力、推理平台还是应用层


美国国内围绕开源的争论,正在从技术路线之争演变为战略路线之争。
一部分美国政治精英固守“控制即安全”的思维,但中国开源模型的巨大成功已在美国国内引发巨大焦虑,“是否应该转向开源”成为美国行业激辩的议题。

两条道路也在互相借鉴。
美国开始重新审视开源策略,中国则在强化学习、底层架构创新上持续投入。
这场竞争远未到终局。


如果一定要用一个最精炼的比喻来总结:美国在熬一锅别人无法复制的老汤,中国在做一块人人都能用的浓汤宝
老汤定义了味道的上限,浓汤宝决定了味道能走多远。
最终,这锅汤会端上全世界的餐桌——问题只是,谁来决定配方,谁来分这碗汤。


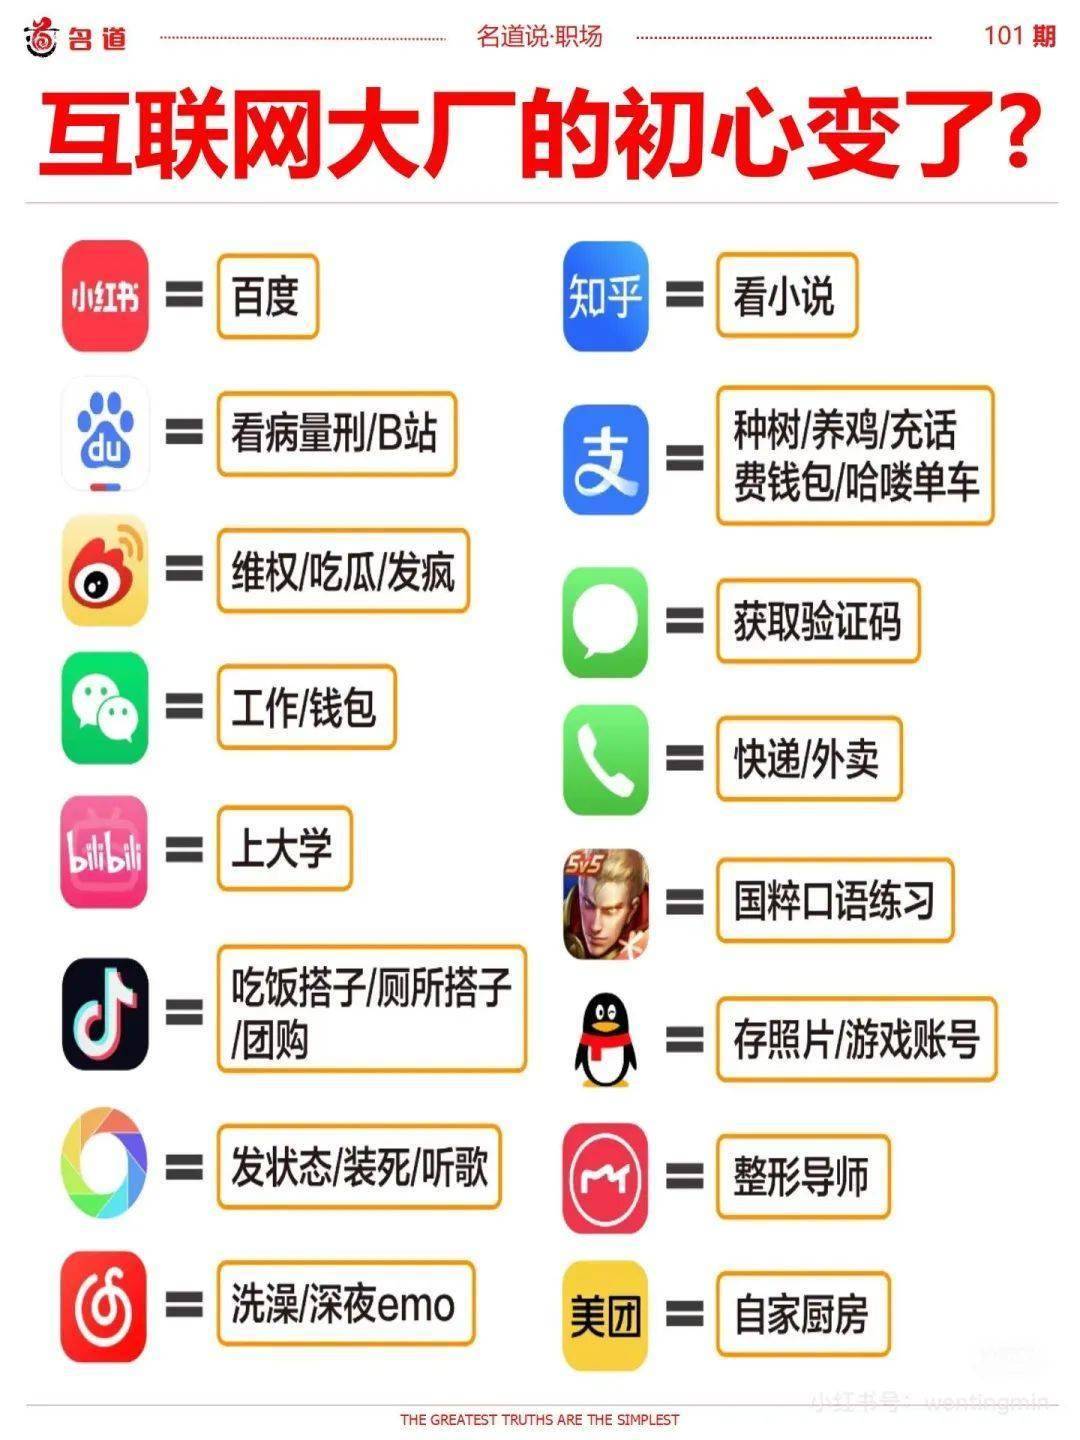
王曦研究苑感慨:如果暂时撇开AI相关,当前,互联网网民的生活习惯已然发生了深刻的变化(如上图)——原本的行为与目的A,现在丝滑地跳跃到了B……下一篇文章我们将重点分析和梳理新时代网民逛网的新趋势!

而回归AI本身,2026年的数据给出的答案是:
配方正在从闭源走向开源,餐桌正在从硅谷扩展到全球
中国开源模型已深入西方生产体系,这场跨太平洋的AI循环才刚刚开始。

来源|王曦研究苑、AI
编辑|悠然  编审|北辰
❖ 合作|投稿|版权问题|读者联系我们
❖ 请联系本站时备注来自:王曦研究苑
➤ 请记住本页唯一标识码:王曦研究苑数据分析29

上一主题上一篇  >>更多王曦研究苑数据分析信息<<  下一篇下一主题

回复 440 王曦研究院 7 天前

使用道具 举报


可爱搜索
Copyright © 1999~ keai.cn All Rights Reserved.
 
快速回复 返回顶部 返回列表
keai.cn主站 频道首页
返回上页
商城
信息