脑机接口为什么会还原患者的原声?难道大脑里也存着“0和1”?Neuralink的新进展

6 人正在可爱逛~
一段23秒的视频,让全世界安静了下来

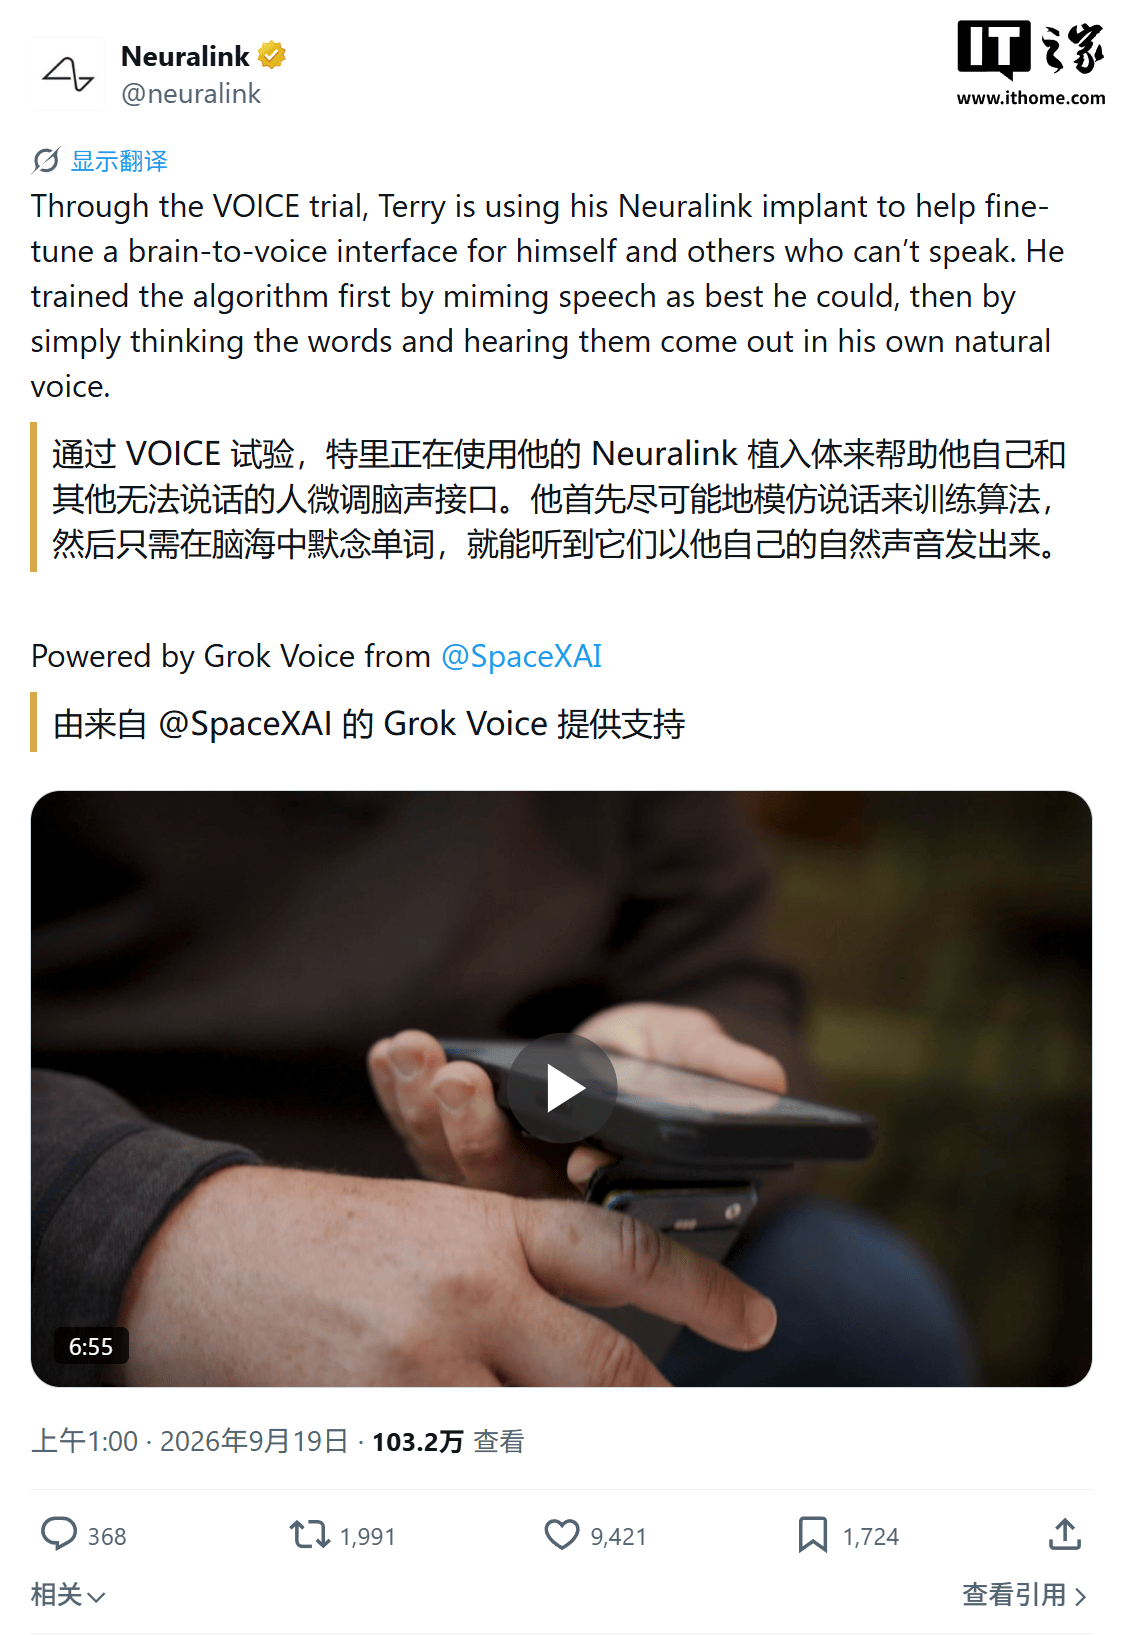
2026年9月,马斯克旗下脑机接口公司Neuralink在社交平台X上发布了一段仅23秒的视频,配文只有四个字:“一个美丽的惊喜”。


视频中,一位名叫Terry的男子没有张嘴,没有发出任何喉部声音,却通过脑机接口系统,用他患病前的声音,向妻子“说出”了“我爱你”。
当那个熟悉的声音再次响起,妻子激动地与他相拥。
马斯克本人随后转发了这段视频,并附上了同样的三个字:“我爱你”。


Terry曾是热爱交流的事业人士,2024年被确诊为肌萎缩侧索硬化症(ALS,俗称“渐冻症”)的延髓起病型,这种类型会早期影响说话和吞咽的肌肉。
随着病情进展,他的言语越来越难以被家人理解,最终彻底失声——大脑完全清醒,却被困在了无法发声的身体里。

这段视频之所以让无数人动容,不仅因为技术的神奇,更因为那个声音——它听起来像Terry本人。
这就引出了一个非常关键的问题:
脑机接口是怎么“找回”患者原声的?
难道每个人的声音真的像计算机文件一样,被大脑以某种“0和1”的形式存储着?


一

最大的误会:大脑里并没有一段“原声录音”

很多人第一次看到这个新闻时,会直觉地以为:
脑机接口读取了大脑里存储的“声音文件”,然后把它播放出来。就像电脑硬盘里存着一首MP3,双击就能播放。

这个直觉是错的。

如果你仔细看Neuralink的官方说明,会发现Terry的训练过程分为几个阶段:
他首先尝试模拟说话来训练算法,然后过渡到只在脑中默念词语,系统便能以他的自然声音输出语音。
注意这里的关键——系统输出的是“以他的自然声音”合成的语音,而不是从大脑中提取的原始音频。


换句话说,脑机接口做的事情是两件完全不同的事的组合:

第一件事:从大脑中读取“我想说什么”的意图——这是语言内容。

第二件事:用AI合成一个“听起来像Terry”的声音来“朗读”这些内容——这是声音身份。

这两件事的原理完全不同,所用的技术也完全不同。把它们分开理解,一切就豁然开朗了。


二

第一步:大脑里存的是“怎么说话”,不是“说话的录音”

要理解脑机接口能做什么、不能做什么,得先搞清楚大脑在“说话”这件事上到底在干什么。

当你想要说“我爱你”这三个字时,你的大脑并不会像播放录音一样“回放”一段声音。
它做的事情更像是指挥一支交响乐团——大脑中负责语音运动的区域(主要在运动皮层和额下回等区域)会向你的嘴巴、舌头、声带、呼吸肌群发送一系列极其精细的运动指令。
你的舌头要放在什么位置、嘴唇要张多大、声带要如何振动、气流要多强——所有这些参数被编排成一个精确到毫秒级的“运动程序”。


科学研究已经揭示,人类语言主导的前额叶皮层中存在编码计划词语语音排列和组成的神经元,这些神经元代表了发音事件的具体顺序和结构。
简单说,大脑编码的是“怎么发出这个声音”的运动指令,而不是声音本身的声波记录。

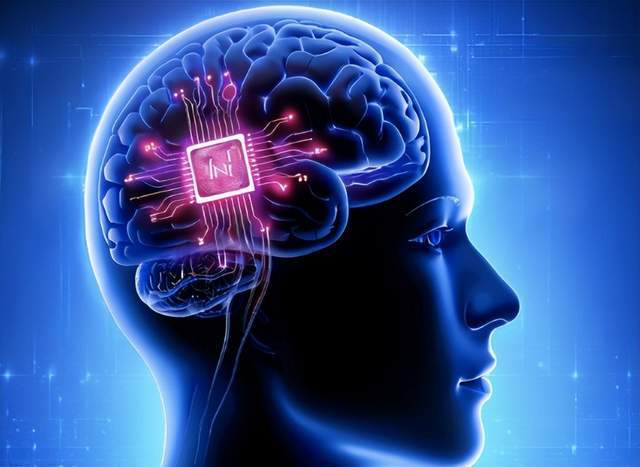
Neuralink的N1芯片植入的正是这个区域。
它的电极丝像头发丝一样细,植入到负责语音规划的大脑皮层中,实时捕捉Terry“意图说话”时产生的神经放电模式。
当Terry在脑中默念“我爱你”时,这些神经元按照特定的时空模式放电,芯片把这些模式记录下来。

接下来的工作是AI的活:
系统通过深度学习算法,将这些神经信号模式解码为音素——语音中最小的声音单位,比如“w”、“o”、“ai”、“n”、“i”等。
然后语言模型将这些音素序列组合成完整的词语和句子。

加州大学戴维斯分校团队的研究显示,在他们测量的神经元群体中,全部39个英语音素都呈现出不同的时空神经活动模式,这使得训练深度学习算法来预测参与者试图说出的音素成为可能。

到这里为止,脑机接口解决的是“说什么”的问题。
但“听起来像谁”,它还没回答。


三

第二步:让声音像“他本人”——AI声音克隆

Terry案例中最动人的部分,是那个声音听起来像他。
但这个“像”,并不是因为大脑里存着他的声音。

在Terry的案例中,Neuralink官方公布的核心流程是:
N1芯片捕捉语言区神经信号 → AI解码成文字 → 用Grok Voice技术合成语音。官方没有详细披露语音模型的训练数据来源,但多家媒体的报道和分析指出,系统使用了Terry患病前的录音来训练个性化的语音模型。

这个技术路线并非Neuralink独有。
加州大学戴维斯分校的团队在一项发表于《科学》杂志的研究中,同样采用了这一策略。
他们与一位因ALS失去清晰说话能力的45岁男性合作,在他大脑的三个语音相关区域植入了256个微电极。
系统在他试图说话时实时预测音素,然后用根据他患病前录音训练的文本转语音软件来朗读句子。

另一位参与Neuralink VOICE试验的患者Kenneth Shock的案例更加具体。Shock在2024年确诊ALS,2026年1月植入了N1芯片。
Neuralink团队找到了他生病前——大约2020年疫情期间——的录音,用AI还原了他的音色。
当设备第一次用“原版Ken”的声音说出“我爱你”时,他的妻子情绪瞬间决堤。

这就是声音克隆的核心逻辑:
AI并不需要从大脑中“提取”声音,它需要的是患者在健康时期留下的声音样本——录音资料越丰富,克隆出的声音就越接近本人。

在ALS领域,这已经形成了一个专门的实践叫“语音银行”(Voice Banking)。
患者在被诊断后,尽早录制大量语音样本,以便未来在失去说话能力后,用这些样本训练出接近自己自然声音的合成语音。
美国ALS协会甚至与AI语音技术公司ElevenLabs合作,为ALS患者提供免费的语音克隆许可。

所以,回到最初的问题:
脑机接口“还原”原声,靠的不是读取大脑中的音频文件,而是用患者健康时期的外部录音作为“原材料”,训练一个AI声音模型,再用这个模型来“朗读”大脑解码出的文字。


四

大脑的“编码” vs 计算机的“0和1”

现在我们可以回过头来,认真回答那个很有意思的直觉问题:难道每个人的原声也像计算机存储一样有0和1?

这个问题其实包含了两层追问:
大脑的信息编码方式是不是二进制的?
大脑里是不是存着声音的“数字副本”?

先说第二个问题,答案已经很清楚了:
不是。
大脑里没有一段“声音录音文件”,它存的是运动指令——一套“怎么说话”的程序。
就像乐谱不是音乐本身,而是演奏音乐的指令一样。

再来看第一个问题,这就有意思了。

计算机确实用0和1工作。每一个比特非0即1,通过极其精确的组合来表示所有信息。
一个字节是8个比特,可以表示256种不同的状态。
计算机的优势在于精确和可复制——同一个文件拷贝一万次,每一个比特都不会出错。

大脑的编码方式则完全不同。神经元之间传递信息主要靠脉冲(Spike) ——一种“全或无”的电信号。
从单个神经元的角度看,它要么放电(可以类比为“1”),要么不放电(“0”)。这确实和二进制有某种形式上的相似。
有神经科学研究甚至发现,听觉皮层中的一些神经元在响应刺激时表现出类似“全或无”的行为。


但大脑的编码远不止于此。
它同时利用了放电频率(一个神经元每秒放电多少次)、放电的时间模式(多个神经元之间放电的时间关系)以及神经元群体的分布式活动模式(成千上万个神经元共同构成的时空格局)来携带信息。
这是一种模拟与脉冲混合的、高度分布式的编码系统,与计算机那种精确的二进制编码有本质区别。

更耐人寻味的是,有研究表明,虽然理论上将语音编码为二进制序列会更高效——因为二进制能比口语更紧密地压缩信息——但人类大脑偏偏选择了看似更“低效”的自然语言。
德国语言学家哈恩和美国加州大学欧文分校的理查德·富特雷尔的研究表明,自然语言之所以呈现这种形态,是因为它围绕熟悉词汇和可预测的模式构建,让大脑能持续预测接下来可能出现什么,从而大幅降低认知负担。

哈恩用了一个很妙的比喻:
这就像通勤上班——我们非常熟悉日常通勤路线,开车几乎像自动驾驶,大脑完全清楚接下来会是什么路况,所以很轻松。
选择一条更短但不熟悉的路线反而会让人累得多。

所以,大脑选择了一种“对大脑来说更容易”的编码方式,而不是“理论上最高效”的编码方式。
这恰恰说明:
大脑的信息处理逻辑和计算机的二进制逻辑,虽然在最底层都有“开/关”的物理基础,但在更高层次上,它们走了完全不同的路。


五

这项技术的未来:从“说话”到“看见”,再到更多

Terry的故事不是一个孤立的奇迹。
它代表着脑机接口在语音恢复领域的一个快速发展的浪潮。

2026年7月,《科学》杂志发表的一篇综述指出,AI语音神经假体已经能够恢复神经系统损伤后的日常交流能力。
Stavisky团队开发的系统在使用第一天就实现了99.6%的准确率(50词词汇量),第二天将词汇扩展到整个英语词典的125,000个词,准确率达到90.2%。
另有研究报告显示,一位瘫痪失语者独立使用脑机接口近两年,共发出183,060个句子(近200万词),平均每分钟56词,其中92%的句子被评定为“基本正确”或更佳。

在中国,脑机接口的进展同样迅速。
“北脑一号”是国际上首个实现失语患者语言解码的无线全植入脑机系统,目前已完成了脊髓损伤患者、脑卒中偏瘫患者以及渐冻症所致言语障碍患者的植入。
中科院团队实现了实时汉语解码和语句合成,音节解码准确率达到71.2%,语句解码速率接近每分钟50字。

而语音恢复只是起点。
马斯克已经公布了“Blindsight”(盲视)项目,旨在绕过眼睛和视神经,直接刺激大脑视觉皮层,为完全失明者恢复视力。
其原理是用安装在眼镜上的小型摄像头捕捉周围环境,将视觉信息转化为电信号,直接写入视觉皮层。
如果这一技术成功,那么脑机接口的“感官修复”版图将从听觉和语言扩展到视觉。

更远的未来,脑机接口可能在四个核心领域同时发力:运动功能修复(帮助瘫痪患者控制机械臂或外骨骼)、听觉功能重建(人工耳蜗的升级版)、语言功能恢复(Terry案例所代表的)、以及视觉功能重建(Blindsight项目)。


写在最后

回到Terry的那句“我爱你”。

当那个声音响起的时候,妻子听到的不仅是一句话,而是她丈夫生病前的声音——那个在她记忆中鲜活的声音。
这个声音不是从大脑里“读”出来的,而是AI用他过去的录音重建的。
大脑提供的是“我想说什么”,而AI提供的是“用什么声音来说”。

这两条技术线的交汇,才造就了那个让全世界为之动容的23秒。

至于“0和1”的疑惑——你的直觉其实指向了一个非常深刻的问题:
信息在大脑和计算机中是以什么方式被表征的?

答案是,它们走的路完全不同。
计算机用精确的二进制编码一切,而大脑用分布式的、动态的、对认知负担敏感的神经脉冲模式来编码——不是最高效的,但对我们的大脑来说是最舒适的。

大脑不是硬盘,它更像一位指挥家。
它不存储音乐的录音,它存储的是如何演奏的指令。
而脑机接口和AI所做的,是读懂这位指挥家的手势,然后找到一把音色最接近原来的乐器,把这首曲子重新演奏出来。

➤ 编辑|悠然  编审|北辰

➤ 合作|投稿|版权问题联系并注明来自 王曦软件

➤ 标识|王曦软件 软件大全 软件快捷键 软件介绍 65


可爱搜索
Copyright © 1999~ keai.cn All Rights Reserved. 小黑屋|
 
快速回复 返回顶部 返回列表
首页 频道
回上页
商业
导航